Questões de Concurso
Filtrar
455 Questões de concurso encontradas
Página 20 de 91
Questões por página:
O Processamento de Linguagem Natural - PLN é uma área da ciência da computação e subárea da Inteligência Artificial - IA, que estuda como os computadores podem entender e processar a linguagem humana. Para tal, nessa área estão envolvidos diversos processos, dentre os quais os mais comuns são: o de ____________, que divide um texto em tokens (unidades significativas: frases, palavras ou símbolos); o de ____________, que reduz uma palavra à sua forma básica; o de ____________, que atribui uma categoria gramatical a cada token; o de____________, que identifica entidades nomeadas em um texto; e o de ____________, que analisa a estrutura sintática de um texto.
Em sequência, as palavras-chave que completam corretamente essas lacunas são:
A figura mostra uma arquitetura de Rede Neural ________________, em que U, W e V são ________________.
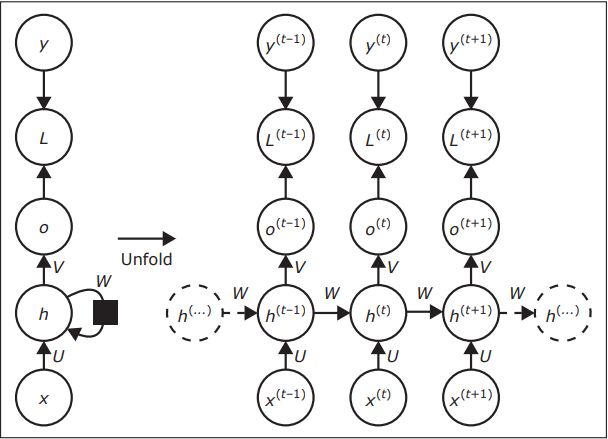
Fonte: GOODFELLOW et al. Deep Leaning. MIT press, 2016 (p. 378). (Adaptado)
Assinale a alternativa que completa corretamente as lacunas.
I? ?? Uma Floresta Aleatória é um método de conjunto projetado especificamente para a classificação com árvores de decisão.
II? ?? Um exemplo de Floresta Aleatória é o algoritmo Ada Boost.
III? ?? Bagging usando Árvores de Decisão é um caso especial de Florestas Aleatórias, em que a aleatoriedade é inserida no processo de construção do modelo, escolhendo aleatoriamente N exemplos, com substituição, a partir do conjunto de treinamento original.
Está(ão) correta(s)
