Questões de Concurso
Filtrar
270 Questões de concurso encontradas
Página 10 de 54
Questões por página:
Questões por página:
Concurso:
Prefeitura de Jaguaquara - BA
Disciplina:
Estatística
A produção diária (em unidades) de uma fábrica ao longo de 5 dias úteis foi: 80,82,78,80,80 Com base nesses dados, analise as afirmativas:
I. A média da produção diária é 80 unidades.
II. A moda da distribuição é 80.
III. O desvio padrão é igual a zero, pois a média e os valores são próximos.
IV. A variância é igual a 4.
Assinale a alternativa correta:
I. A média da produção diária é 80 unidades.
II. A moda da distribuição é 80.
III. O desvio padrão é igual a zero, pois a média e os valores são próximos.
IV. A variância é igual a 4.
Assinale a alternativa correta:
Concurso:
Prefeitura de Senador Canedo - GO
Disciplina:
Estatística
Um professor aplicou uma prova em uma de suas turmas e as notas foram as seguintes: 5,5,6,7,7,8,8,9,10,10. Ele resolveu calcular a razão entre a mediana e a amplitude desse conjunto de dados, pois isso lhe dará uma ideia da posição do centro dos dados em relação à dispersão total. Qual o valor dessa razão?
Concurso:
Prefeitura de Rio Verde - GO
Disciplina:
Estatística
A distribuição do valor pago mensalmente aos funcionários de uma empresa hoteleira está representada no quadro abaixo:
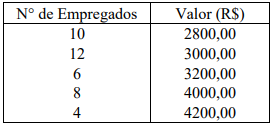
De acordo com as informações do quadro, o valor do salário médio pago mensalmente pela empresa é de:
De acordo com as informações do quadro, o valor do salário médio pago mensalmente pela empresa é de:
Concurso:
MPE-ES
Disciplina:
Estatística
Um cientista de dados está desenvolvendo um modelo de segmentação para classificar procedimentos com base em características quantitativas.
Para garantir a comparabilidade entre variáveis, ele aplicou a padronização por escore z (z-score) em um conjunto de dados multivariados, de modo que todas as variáveis passassem a apresentar média 0 e desvio-padrão 1.
Após a padronização, verificou-se que os dados não apresentavam forte separação entre grupos naturais. Em seguida, foi aplicado o algoritmo K-means em Python:
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
kmeans = KMeans(n_clusters=3, n_init=10, random_state=0)
kmeans.fit(X_scaled)
print(kmeans.cluster_centers_)
Observou-se que os centroides obtidos apresentam valores próximos de zero em todas as dimensões.
Considerando o contexto descrito, esse resultado ocorre porque
Para garantir a comparabilidade entre variáveis, ele aplicou a padronização por escore z (z-score) em um conjunto de dados multivariados, de modo que todas as variáveis passassem a apresentar média 0 e desvio-padrão 1.
Após a padronização, verificou-se que os dados não apresentavam forte separação entre grupos naturais. Em seguida, foi aplicado o algoritmo K-means em Python:
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
kmeans = KMeans(n_clusters=3, n_init=10, random_state=0)
kmeans.fit(X_scaled)
print(kmeans.cluster_centers_)
Observou-se que os centroides obtidos apresentam valores próximos de zero em todas as dimensões.
Considerando o contexto descrito, esse resultado ocorre porque
Concurso:
TJ-CE
Disciplina:
Estatística
Considere:
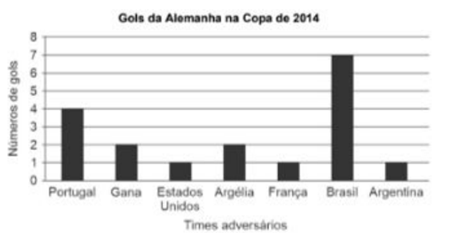
A partir do gráfico de barras, podemos construir um intervalo que é dado pela média de gols da Alemanha por jogo, mais ou menos a amplitude do número de gols. Aproximando o valor da média com duas casas decimais, esse intervalo é dado por
A partir do gráfico de barras, podemos construir um intervalo que é dado pela média de gols da Alemanha por jogo, mais ou menos a amplitude do número de gols. Aproximando o valor da média com duas casas decimais, esse intervalo é dado por
