Questões de Concurso
Filtrar
435 Questões de concurso encontradas
Página 31 de 87
Questões por página:
Um gestor público de políticas de desenvolvimento agrícola deseja avaliar se três diferentes fórmulas de biofertilizante (F1, F2, F3) produzem efeitos distintos sobre o crescimento inicial de mudas de espécies nativas destinadas a projetos de recuperação de áreas degradadas. Para isso, foi conduzido um experimento completamente casualizado com 60 parcelas homogêneas. As parcelas foram aleatorizadas para receber um dos três fertilizantes (n = 20 por grupo). A variável resposta é o incremento em altura (cm) após 60 dias. Após a coleta dos dados, o gestor observa que a distribuição dos resíduos do modelo apresenta leve assimetria à direita e caudas ligeiramente mais pesadas que a distribuição normal. Ele decide testar a homogeneidade das variâncias entre os grupos (teste de Levene, p = 0,12). O tamanho amostral por grupo é razoável (n = 20), e o interesse primário é comparar as médias dos três grupos, controlando o erro tipo I em 5%.
Com base nesse cenário e nos princípios de estatística experimental, assinale a alternativa CORRETA quanto à técnica mais apropriada para a análise dos dados, justificando os pressupostos e possíveis alternativas.
Em uma avaliação de impacto de um novo programa de atenção primária à saúde, um gestor público modela a probabilidade de óbito em até 30 dias (variável resposta binária: 1 = óbito, 0 = sobrevida) usando regressão logística binária, com variáveis explicativas: idade, índice de comorbidades, adesão ao protocolo e condição socioeconômica. Em relação à teoria e prática da regressão logística, julgue os itens a seguir:
I. O modelo de regressão logística estima a probabilidade P(Y = 1 ? X) = 1 / 1+e?X?, sendo que os parâmetros ? são obtidos por máxima verossimilhança (MV), e diferentemente do modelo linear de probabilidade (MLP), os valores preditos ficam restritos ao intervalo [0,1].
II. Se o coeficiente estimado para idade for ?idade = 0,05, a interpretação é que um aumento de uma unidade na idade está associado a um aumento de 5% na probabilidade de óbito, mantendo as demais variáveis constantes.
III. O modelo logístico não requer normalidade dos resíduos nem homocedasticidade, mas exige independência das observações e ausência de multicolinearidade perfeita ou quase perfeita.
IV. A área sob a curva ROC (AUC) é uma medida de acurácia discriminativa do modelo: valores próximos a 0,5 indicam discriminação aleatória, enquanto valores acima de 0,8 sugerem bom poder discriminativo.
V. O teste de Hosmer-Lemeshow é frequentemente usado para avaliar a calibração do modelo logístico, ou seja, se as probabilidades preditas correspondem às frequências observadas. Um resultado não significativo (p > 0,05) indica boa calibração.
Assinale a alternativa com a sequência CORRETA (V/F):
Ao realizar um teste de hipóteses para a média de uma população com amostras pequenas (n < 30) e desvio padrão populacional desconhecido, a distribuição t de Student é a mais apropriada para construir o intervalo de confiança ou calcular o valor p. Em relação à teoria da distribuição t e sua aplicação, julgue os itens a seguir:
I. A estatística de teste 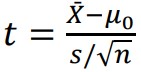 segue exatamente uma
distribuição t de Student com n ? 1 graus de liberdade
se a população for normal. Se a população não for
normal, mas for simétrica e com curtose moderada, o
teste t ainda é razoavelmente robusto para amostras
pequenas.
II. A distribuição t de Student tem caudas mais pesadas que a distribuição Normal padrão, mas à medida que os graus de liberdade aumentam, a t se aproxima da Normal. Para n ? 30, a diferença é geralmente considerada desprezível na prática.
III. O intervalo de confiança para a média usando a
distribuição t é dado por 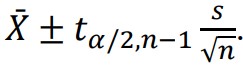 Se,
erroneamente, usássemos o quantil da Normal (Z?/2) no
lugar do t, o intervalo seria mais estreito, aumentando a
probabilidade de não conter o verdadeiro parâmetro
(cobertura abaixo do nominal).
IV. Para testar a média de uma população com amostra pequena e desvio padrão desconhecido, a distribuição Qui-quadrado (X 2) seria apropriada se o interesse fosse na variância, não na média. Já a distribuição F é usada para comparação de duas variâncias ou em ANOVA.
V. A estatística t de Student para uma amostra pode ser derivada como razão entre uma Normal padrão e a raiz quadrada de uma Qui-quadrado dividida por seus graus de liberdade, assumindo independência. Essa relação justifica o nome “t” e a forma da densidade.
Assinale a alternativa com a sequência CORRETA (V/F):
Um analista de confiabilidade está interessado em estudar o tempo médio entre falhas consecutivas (TBF – Time Between Failures) em equipamentos hospitalares de alta complexidade. Para modelar essa variável aleatória contínua e não negativa, a distribuição Exponencial é frequentemente utilizada. Em relação às propriedades da distribuição Exponencial e suas aplicações em análise de confiabilidade, julgue os itens a seguir:
I. Se T ~ Exponencial (?) (com função densidade ƒ(t) = ? e??t , t ? 0, e média 1/?), então a função de risco (taxa de falha) é constante e igual a ?, o que caracteriza ausência de memória: P (T > t + s ? T > s) = P (T > t).
II. A distribuição Exponencial é o único modelo contínuo com propriedade de falta de memória, e isso a torna inadequada para modelar equipamentos com desgaste (taxa de falha crescente), mas adequada para falhas aleatórias não relacionadas ao envelhecimento.
III. Se o número de falhas em um intervalo de tempo segue um processo de Poisson homogêneo com taxa ?, então o tempo entre falhas consecutivas segue uma distribuição Exponencial com média 1/?. Além disso, o tempo até a k-ésima falha segue uma distribuição Gama (Erlang) com parâmetros k e ?.
IV. Para uma amostra aleatória T1, T2, … , Tn i.i.d. Exponencial(?), o estimador de máxima verossimilhança de ? é ? = 1/T?, que é um estimador não viesado para ?.
V. O coeficiente de variação (CV) da distribuição Exponencial é igual a 1, independentemente do valor de ?, o que significa que o desvio padrão é igual à média. Esse é um critério diagnóstico útil para verificar a adequação do modelo exponencial a dados empíricos.
Assinale a alternativa com a sequência CORRETA (V/F):
Em uma análise de desempenho institucional, um estatístico precisa comparar a dispersão de indicadores de produtividade entre departamentos com médias e escalas distintas. Ele utiliza inicialmente o desvio padrão amostral. Em relação às propriedades, limitações e relações do desvio padrão com outras medidas estatísticas, julgue os itens a seguir:
I. Se os dados de um departamento seguem uma distribuição assimétrica à direita, o desvio padrão é necessariamente maior do que o desvio médio absoluto (MAD), devido à maior ponderação dos desvios quadráticos.
II. O coeficiente de variação (CV) é uma medida adimensional que permite comparar dispersão entre variáveis com diferentes unidades, mas sua utilização é inadequada quando a média se aproxima de zero, independentemente da natureza dos dados.
III. Para uma amostra aleatória simples de uma população com variância finita, o desvio padrão amostral (com correção de Bessel) é um estimador não viesado do desvio padrão populacional.
IV. Se todos os valores de um indicador forem transformados por Y = ? + bX, com b > 0, o desvio padrão de Y é igual a b vezes o desvio padrão de X, independentemente do valor de ?.
V. Em qualquer distribuição com média finita e variância finita, a desigualdade de Chebyshev garante que a proporção de observações dentro de k desvios padrão da média é de pelo menos 1 ? 1/k2 , sendo essa uma cota superior para qualquer distribuição.
Assinale a alternativa com a sequência CORRETA (V/F):
