Questões de Concurso
Filtrar
4.053 Questões de concurso encontradas
Página 11 de 811
Questões por página:
Questões por página:
Concurso:
MPE-ES
Disciplina:
Estatística
Para estimar um parâmetro associado a uma variável aleatória, foi adotado o seguinte procedimento:
1. Inicialmente, foi definida uma distribuição de probabilidade para o parâmetro de interesse com base em conhecimento prévio, sem considerar os dados da amostra;
2. Em seguida, foram coletadas observações da variável aleatória e especificado um modelo estatístico que descreve como esses dados se relacionam com o parâmetro de interesse;
3. Depois disso, a distribuição inicialmente atribuída ao parâmetro foi revista à luz das informações fornecidas pela amostra observada; e
4. Por fim, a partir da distribuição obtida após essa revisão, foram calculadas estimativas da média e da variância do parâmetro de interesse.
O procedimento descrito corresponde ao(à)
1. Inicialmente, foi definida uma distribuição de probabilidade para o parâmetro de interesse com base em conhecimento prévio, sem considerar os dados da amostra;
2. Em seguida, foram coletadas observações da variável aleatória e especificado um modelo estatístico que descreve como esses dados se relacionam com o parâmetro de interesse;
3. Depois disso, a distribuição inicialmente atribuída ao parâmetro foi revista à luz das informações fornecidas pela amostra observada; e
4. Por fim, a partir da distribuição obtida após essa revisão, foram calculadas estimativas da média e da variância do parâmetro de interesse.
O procedimento descrito corresponde ao(à)
Concurso:
MPE-ES
Disciplina:
Estatística
Analise a tabela a seguir.
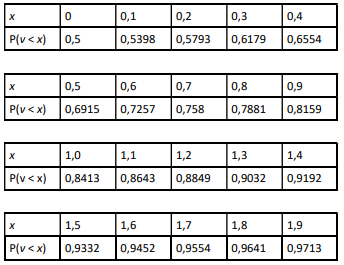
Seja v uma amostra de uma variável aleatória gaussiana de média 0 e variância 1. A tabela acima mostra a probabilidade de v ser menor que alguns valores x entre 0,0 e 1,9.
Uma segunda variável aleatória w também é uma distribuição gaussiana, porém de média 1 e variância 4.
A probabilidade da soma de 16 amostras independentes de w ser maior que 24 é
Concurso:
MPE-ES
Disciplina:
Estatística
O cerne da obra de Mark Monmonier, “Como mentir com mapas”, decorre de escolhas cartográficas, seja por omissão, simplificação ou classificação, necessárias para representar fenômenos complexos, mas que podem influenciar a interpretação do mapa. No caso dos mapas temáticos, isso inclui a classificação de valores numéricos ao longo de um intervalo contínuo.
Assinale a opção que indica o critério de classificação que divide as feições em classes que possuem a mesma frequência de registros.
Assinale a opção que indica o critério de classificação que divide as feições em classes que possuem a mesma frequência de registros.
Concurso:
MPE-ES
Disciplina:
Estatística
No contexto de mineração de dados, um analista utilizou as técnicas de regras de associação (como o algoritmo Apriori) para identificar padrões de concorrência entre ilícitos em processos administrativos.
Ao analisar a regra de associação {Desvio de Verba} → {Falsidade Ideológica}, foram obtidos os seguintes valores:
• Confiança = 0,80;
• Lift = 2,0.
Assinale a opção que apresenta a interpretação tecnicamente correta para o valor do Lift obtido.
Ao analisar a regra de associação {Desvio de Verba} → {Falsidade Ideológica}, foram obtidos os seguintes valores:
• Confiança = 0,80;
• Lift = 2,0.
Assinale a opção que apresenta a interpretação tecnicamente correta para o valor do Lift obtido.
Concurso:
MPE-ES
Disciplina:
Estatística
Um cientista de dados está desenvolvendo um modelo de segmentação para classificar procedimentos com base em características quantitativas.
Para garantir a comparabilidade entre variáveis, ele aplicou a padronização por escore z (z-score) em um conjunto de dados multivariados, de modo que todas as variáveis passassem a apresentar média 0 e desvio-padrão 1.
Após a padronização, verificou-se que os dados não apresentavam forte separação entre grupos naturais. Em seguida, foi aplicado o algoritmo K-means em Python:
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
kmeans = KMeans(n_clusters=3, n_init=10, random_state=0)
kmeans.fit(X_scaled)
print(kmeans.cluster_centers_)
Observou-se que os centroides obtidos apresentam valores próximos de zero em todas as dimensões.
Considerando o contexto descrito, esse resultado ocorre porque
Para garantir a comparabilidade entre variáveis, ele aplicou a padronização por escore z (z-score) em um conjunto de dados multivariados, de modo que todas as variáveis passassem a apresentar média 0 e desvio-padrão 1.
Após a padronização, verificou-se que os dados não apresentavam forte separação entre grupos naturais. Em seguida, foi aplicado o algoritmo K-means em Python:
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
kmeans = KMeans(n_clusters=3, n_init=10, random_state=0)
kmeans.fit(X_scaled)
print(kmeans.cluster_centers_)
Observou-se que os centroides obtidos apresentam valores próximos de zero em todas as dimensões.
Considerando o contexto descrito, esse resultado ocorre porque
